先把生成、判断和执行分层
通用大模型擅长规划、解释、生成与跨步骤推理,但 Agent 内部还有大量更窄的问题:该调用哪个工具、搜索结果是否相关、风险落在哪个等级、是否需要人工介入。这些问题的共同点不是“简单”,而是输出空间可以提前定义。
Jev 的工程意义不在于返回 JSON。结构化输出同样可以返回 JSON。区别在于 Jev 从接口层就把任务限定为 Choice、Score 或 Noul,使系统拿到的是概率决策,而不是需要再次解释的文本。
什么任务值得拆成快判断
一个任务是否适合 Jev,可以先看四个条件:选项能否枚举、调用是否高频、错误是否能够回退、是否需要语义理解但不需要长篇解释。满足得越多,越适合从生成链路中拆出。
- 工具路由与动作选择
- 相关性、质量与风险评分
- 内容保留、权限请求与人工门禁
- 写作、解释与开放式创作
- 跨文件、多步骤复杂规划
- 答案无法事先定义的探索
Jev 最适合的位置,不是 Agent 的大脑,而是 Agent 的反射神经。
案例:上下文压缩不是摘要
Coding Agent 的上下文通常不是被用户消息撑满,而是被文件内容、搜索结果、命令日志和目录树撑满。传统摘要虽然节省 token,却可能把文件路径、错误码、栈位置和命令参数改写成“意思差不多”的文字。
fast-jev-compaction 选择另一条路线:用户与助手文本保持原样,只对成对的工具调用和工具结果做保留决策。重要内容完整保留,次要结果截断,无关调用整体删除。
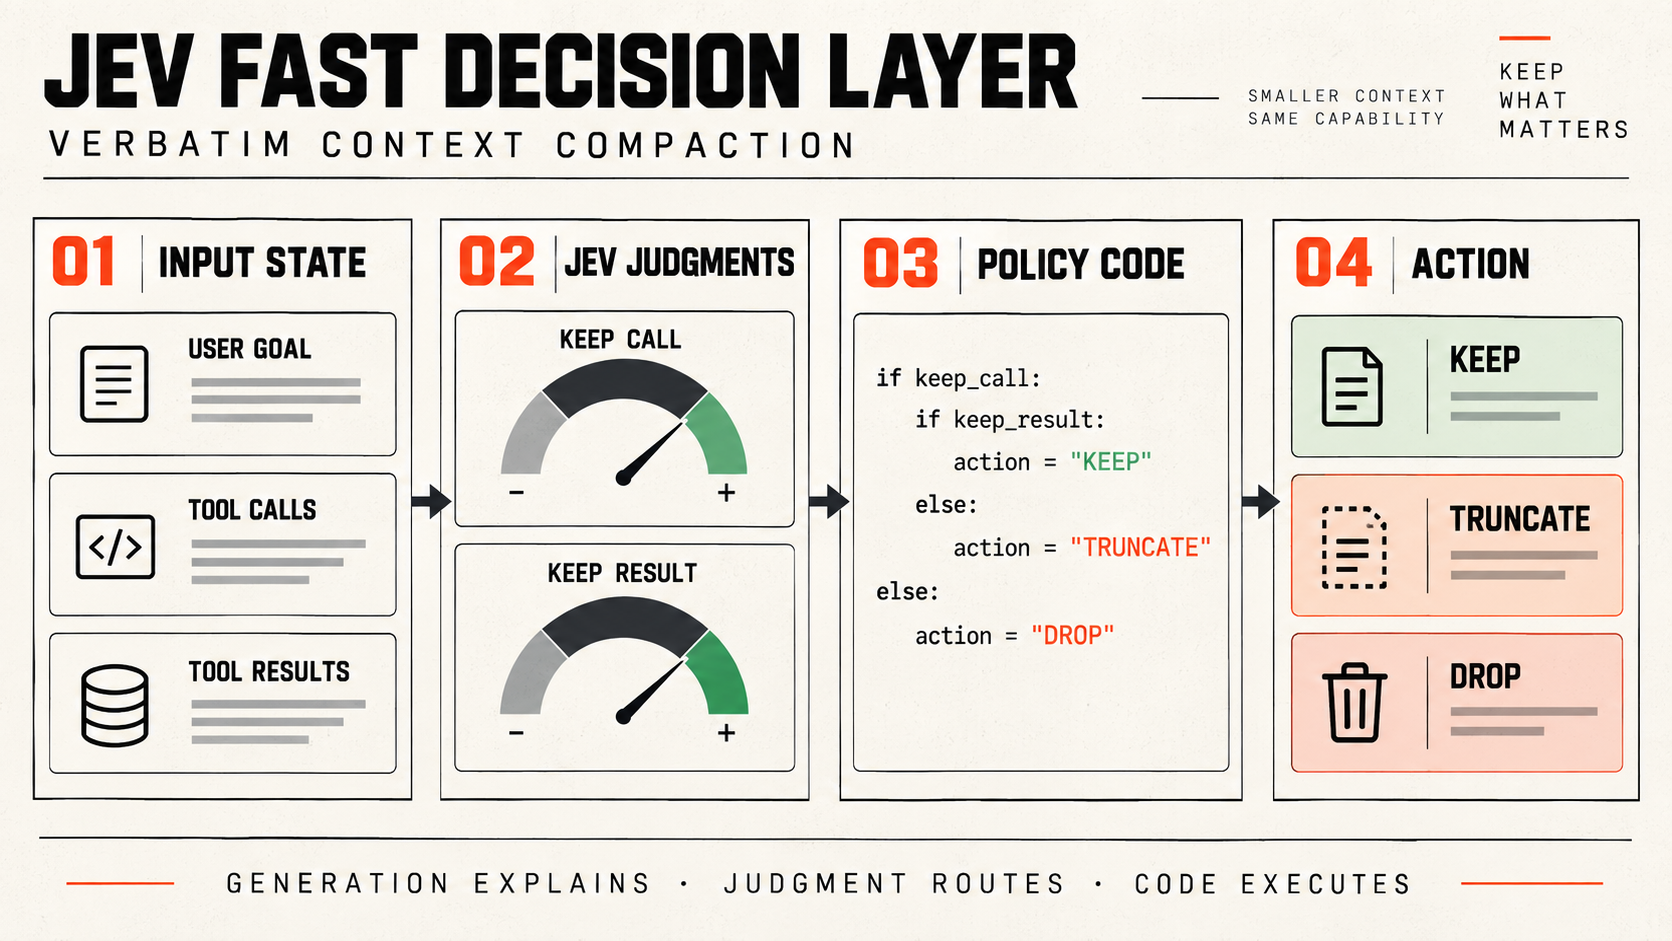
从历史消息到三种压缩动作
- 01collectToolCalls
按 tool_use_id 配对调用与结果,固定首条消息和最近消息。
- 02fitState
只构造判断所需状态,不把全部工具结果再次送入模型。
- 03batchCalls
预算不足时分批生成问题,并行请求 Jev。
- 04decideCall
把两个概率合并成 keep、drop_result 或 drop_call。
把复合问题拆成两个 Noul
questions = {
  call_t3: {
    type: 'noul',
    instructions: 'Is knowing this tool call still useful?'
  },
  result_t3: {
    type: 'noul',
    instructions: 'Must the full result remain available?'
  }
}
keepResult ≥ threshold完整保留调用与结果都保持原文。
keepCall ≥ threshold截断结果保留调用,结果只留提示。
两者都低成对删除避免孤立调用或孤立结果。
状态预算与逐级降级
状态超出预算时,不应直接随机删消息。更稳妥的顺序是先缩短输入,再折叠旧文本,最后才省略旧消息与合并旧调用。每一级降级都应该留下可观测指标。
full工具输入最多 1000 字符
inputs ≤ 200 / 60逐级压缩工具参数
texts abridged长文本保留头尾
old messages collapsed旧消息折成省略说明
old calls merged最后才合并连续旧调用
阈值、回退与上线策略
文章里的 0.5、0.8 等阈值只能用于解释流程,不能直接成为生产默认值。置信度不是安全证明,阈值必须结合自己的标注样本、误判成本和动作可逆性校准。
搜索、分类、重排,可在验证后自动化。
截断上下文、创建临时记录;不确定时保守保留。
删除、扣款、关闭权限,不应由 Jev 单独决定。
- 先在 shadow mode 中记录判断,不改变真实行为。
- 按概率区间统计实际正确率,而不是只看平均值。
- 请求失败、格式异常或收益不足时回退到原流程。
- 记录模型版本、问题版本、阈值、动作和人工覆盖。
Jev、结构化输出还是分类器
适合低频、复杂、需要解释的判断;代价是完整生成链路。
适合 Agent 主流程动作,但选择仍由生成模型完成。
适合稳定标签与大量训练数据,便宜且可本地部署。
适合高频、封闭、需要语义泛化且可回退的局部判断。
类型安全意味着模型不会返回约定之外的形状,不意味着它不会选错。
沉淀为可复用的 Agent 模式
fast-jev-compaction 的价值不只是一种压缩算法,而是示范了稳定的决策协议:对象先结构化,判断拆成原子问题,概率由代码组合,副作用由确定性策略掌控,失败时能完整回退。
这套模式同样适用于工具路由、内容审核、搜索重排、权限请求和质量门禁。真正值得复用的不是某个演示阈值,而是“模型可替换、决策协议稳定”的边界。